

ローカル・クラウドLLMの違い|セキュリティリスクを徹底比較
更新日:9月14日

IPA「情報セキュリティ10大脅威2026」で「AIの利用をめぐるサイバーリスク」が3位に初選出されたほか、OWASPも「LLMトップ10」でプロンプトインジェクションへの警戒を強めるなど、生成AI(大規模言語モデル:LLM)の本番運用におけるセキュリティ対策は企業にとって、必須の課題となりました。(参考:2,3)
中でも、LLMの運用形態は、自社サーバーなどで運用する「ローカルLLM」と、APIやSaaSを介して外部インフラを利用する「クラウドLLM」の2つに大別されますが、双方の「セキュリティリスクの違い」に大きな注目が集まっています。
本記事では、両者の構造的・機能的な違いをはじめ、セキュリティリスクの対比、自社に最適な選定基準から実務的な安全対策までを分かりやすく徹底解説します。


INDEX

なぜ今、LLMの「セキュリティリスク」注目されるのか

AI利活用が経営課題に直結したことで、IPAの「情報セキュリティ10大脅威2026」で「AIの利用をめぐるサイバーリスク」が初選出・3位に入り、生成AIは企業の事業継続と信頼を左右するリスク領域として公式に位置付けられました。
▶︎IPA「情報セキュリティ10大脅威2026」でAI関連リスクが初選出・3位に
独立行政法人 情報処理推進機構(IPA)が2026年に公表した「情報セキュリティ10大脅威2026」では、組織向けの脅威ランキングにおいて「AIの利用をめぐるサイバーリスク」が初選出で3位にランクインしました。
同ランキングは2024年・2025年を通じてランサムウェアが1位を占めていましたが、2026年版で初めてAI関連項目が全社的な経営リスクとして公式に位置付けられた点は象徴的であり、AIのセキュリティ対策が企業経営における最優先課題の一つになったことを如実に示しています。(参考:2)
▶︎「OWASP Top 10 for LLM Applications 2026」で露呈した構造的リスク
セキュリティ研究コミュニティでは、OWASP(Open Worldwide Application Security Project)が「OWASP Top 10 for LLM Applications 2026」を公開し、LLMを組み込んだシステムに固有の10カテゴリーのリスクを体系化しています。 1位は前回に引き続き「プロンプトインジェクション」で、ユーザー入力と命令が同じ経路で処理されるLLMの構造的弱点を突く攻撃が依然として最重要とされます。2位も前回と同様「機密情報の開示」ですが、3位にはAIエージェント活用に増加に伴い「過剰なエージェンシー」、4位は「サプライチェーン」、5位は「データ・モデル汚染」と続き、いずれもクラウド・オンプレを問わず発生する設計上の課題です。(参考:3)

ローカルLLMとクラウドLLMの根本的な違い

クラウドLLMは外部のAPIやSaaSを通じて最先端のモデルを手軽に高速導入できる一方、データが組織の外へ送信されます。対してローカルLLMは、組織内のサーバーで行うためデータを完全にコントロール可能ですが、高額なインフラ費用と運用の手間に課題があります。
▶︎ローカルLLMとは?(オンプレミス・自社環境での運用)
ローカルLLMとは、自組織が管理するオンプレミス(自社設置)サーバー(オンプレミス環境)や、専用のプライベートクラウド上にLLM(機械学習モデル)を展開し、自社管理環境で稼働・推論を行う運用形態です。
最大の特性は、入力プロンプト、生成結果、追加学習、RAG参照といったすべてのデータ処理が自社のネットワーク内で完結する点にあります。外部サーバーへデータを送信しないため、物理的・論理的に外部と遮断した「エアギャップ運用」も可能です。(参考:8)
ローカルLLMの主なメリット(セキュリティとデータ管理権)
●高いデータ安全性と管理権限
入力データが外部に送信されないため、個人情報や極めて機密性の高い社内ナレッジを活用する際にも、安全な運用が期待できます。
ローカルLLMの主なデメリット(導入コストと運用負荷)
●高額な初期導入コスト
高性能GPUを搭載したAIサーバーなど、稼働に必要なインフラ環境の構築に大きな費用がかかります。
●自社での運用・保守負荷
ハードウェアの調達、推論速度の最適化、継続的なモデル更新、脆弱性パッチの適用などを自社のエンジニアリソースで対応する必要があります。
ローカルLLMの代表的なモデル・導入の選択肢
オープンソースモデルを中心に、日本語性能に優れた軽量モデル「tsuzumi(NTT)」のほか、「Llama 3(Meta)」、「Qwen(Alibaba)」、マルチモーダルに対応した「Gemma3(Google)」などが活用されています。
▶︎クラウドLLMとは?(API・SaaS利用での運用)
クラウドLLMとは、外部のクラウド事業者(AIプロバイダー)が管理・運用するサーバー上のモデルを、インターネットやAPI経由、あるいはSaaSアプリを通じてオンデマンドで利用する運用形態です。 最大の特性は、自社で高額なインフラを用意することなく、APIキーの発行やライセンス契約のみで、最先端の高性能モデルを即座に利用できる点にあります。常にアップデートされる最先端のAI機能を柔軟に業務へ組み込めます。
クラウドLLMの主なメリット(コスト抑制と運用の軽さ)
●低コストかつスピーディーな導入
高額なGPUサーバーの購入・維持が不要で、初期投資を大幅に抑えて即日利用を開始できます。
●運用・保守の手間を大幅削減
モデルのアップデートやインフラのメンテナンスはすべて提供元に一任できるため、自社での運用負担が極めて少ないです。
クラウドLLMの主なデメリット(データ漏洩リスクと管理の依存)
●データガバナンスとコンプライアンスの課題
入力データが社外のクラウド環境へ送信されるため、個人情報や知的財産の取り扱いに細心の注意が必要です。(参考:5)
●事業者ポリシーへの依存
セキュリティやログの取り扱いルールをクラウド事業者の仕様に依存するため、自社独自の厳格な運用基準を完全には適用しにくい場合があります。(参考:6)
クラウドLLMの代表的なモデル・導入の選択肢
主要AIベンダーが提供するモデルを中心に、「ChatGPT API / Enterprise(OpenAI)」、「Azure OpenAI Service(Microsoft)」、「Gemini API / Vertex AI(Google)」、「Claude API / Claude for Enterprise(Anthropic)」などが活用されています。(参考:4)
【比較表】特徴・コスト・運用スピードの違い
以下は、一般的なクラウドLLMとローカルLLMの特徴を比較したものです。

【リスク徹底比較】ローカルLLM vs クラウドLLMのセキュリティ課題

クラウドLLMの主なリスクは入力データの二次利用とシャドーAI、ローカルLLMの主なリスクはモデル流出とインフラ脆弱性と更新遅れです。両者は本質的に異なる性質の脅威であり、ガバナンスで対応が異なります。
▶︎クラウドLLMのリスク(二次利用・プロンプトインジェクション・シャドーAI)
クラウドLLMをビジネスで利用する際、入力データが事業者の管理するインフラを通過するという性質上、以下の3つのセキュリティリスクが中心となります。
1.入力データ(プロンプト)の二次利用・無断学習リスク
一般消費者向け(無料ツールなど)の生成AIサービスでは、入力した営業秘密や個人データがモデルの再学習に二次利用されるリスクがあります。入力データが学習されると、将来的に他者の回答として自社の機密情報が出力・漏えいするおそれがあります。
OpenAI等のAPI経由でご利用の場合、送信した入力データは原則としてモデルの再学習に使用されませんが、Web版のチャットUIでは明示的にオプトアウトしない限り、別経路でデータが学習に使われるケースがあるため、法人での利用には利用可能なプランチェックが必要です。(参考:4,5)
2.「プロンプトインジェクション」による不正操作や情報漏えい
プロンプトインジェクションは、攻撃者がWebページや添付ファイルなどに忍ばせた悪意ある命令をAIが読み込むことで、意図しない動作を引き起こす脅威です。セキュリティ指標「OWASP LLM Top 10」でも最重大リスクとして挙げられており、LLMの挙動や接続ツールが乗っ取られることで、システムプロンプトの開示、APIキーの盗用、さらには内部データの外部送信や権限昇格といった深刻な被害につながるおそれがあります。
また、クラウドLLMがWeb検索やメール、外部データベース(RAG)といった外部システムと連携している場合、「間接プロンプトインジェクション(Indirect Prompt Injection)」による被害リスクも高まります。(参考:3)
3.「シャドーAI(Shadow AI)」による管理外の情報流出
会社が公式に認めていない生成AIサービスを従業員が業務で無断利用する状態を「シャドーAI」と呼びます。PagerDutyが2026年に公表したグローバル調査(米・英・豪・日)では、業務でAIを使用した経験がある従業員の66%が「会社のポリシーで許可されていない」と認識しながら職場でAIツールを利用していると回答しました。(参考:9)
こうした管理外のクラウドAIに個人情報やソースコード、営業秘密などを入力した場合、外部サーバーへの蓄積だけでなく、AIの追加学習を通じて第三者への意図しない情報開示リスクが発生します。さらに、無断で導入された外部プラグイン等を経由したマルウェア感染など、IT部門の把握できない場所で深刻なコンプライアンス違反へと発展する危険性も秘めています。
なお、ローカル環境で動かすLLM(いわゆる野良LLM)も管理外のAI利用という点で同様の懸念が存在しますが、導入の手軽さという観点から、クラウド型の生成AIサービスにおいてシャドーAIが発生するリスクが特に高いと予測されます。
▶︎ローカルLLMのリスク(モデルアセット流出・インフラ脆弱性・更新遅れ)
「自社環境だから絶対に安全だ」という思い込みは、ローカルLLM構築において最も危険な盲点となります。以下の3点はオンプレ運用に固有のリスクです。(参考:8)
1. 「モデルアセット(重みやパラメータ)」そのものの窃取・流出
自社データでファインチューニングしたローカルLLMの「モデルの重み(Weights)」は、企業の競争力を左右する重要な知的財産です。
ローカル環境のサーバーアクセス権限管理が不十分であったり、内部不正が発生した場合、数GB〜数十GBに及ぶ重みファイルやデータベースが丸ごと窃取・持ち出されるリスクが存在します。
外部ベンダーや共同研究先、退職者などを経由してモデルアセットが一度流出すると、攻撃者に自社専用モデルを完全に再現され、悪用や特化型攻撃の設計に利用される危険性があります。
2. インフラ・物理サーバー層の脆弱性と「セキュリティ・バイ・デザイン」の不備
ローカル環境では、OS、ミドルウェア、GPU用ソフトウェア(ドライバ等)、ネットワーク、物理的な施錠管理に至るまで、すべてのセキュリティ構築責任が自社に生じます。
そのため、開発の上流工程から安全性を組み込む「セキュリティ・バイ・デザイン」を徹底しないと、システム全体のセキュリティホール(脆弱性)を突かれ、サーバー内部に直接侵入されてインフラ全体が乗っ取られる危険性があります。
3. 最新モデルや安全パッチへの追従遅れによる脆弱性放置
LLMの技術革新やセキュリティ脆弱性の修正スピードは非常に高速です。
クラウドLLMであればベンダー側が即座に脆弱性を塞ぎますが、ローカルLLMの場合は、自社のエンジニアが自力でパッチを適用し、データベースを監視し、テストを行い、不具合対応し、環境を再デプロイする必要があるため、更新遅れによる脆弱性の放置リスクが高まります。
▶︎機密データ保護・コンプライアンス・アクセス権限管理における直接対比
ローカルLLMとクラウドLLMのセキュリティ特性を直接対比したのが以下の要素です。

自社に最適なLLMの選び方|データ×リソースで決める選択基準

データの機密性が高く社内に運用リソースがあるならローカル、スピードと性能が優先ならクラウド、両者を併存させるハイブリッド構成が多くの日本企業の現実解です。
▶︎取り扱うデータの機密性レベル(極秘・社内限定・公開)
すべてのデータを同じLLM基盤に流すのはリスク上推奨されません。データの機密性レベルを3段階に整理し、リスクベースアプローチ(リスクの大きさに対応させて対策強度を決める考え方)を採用するのが合理的です。(参考:5,6)

●極秘情報・重要プライバシー情報
原則として、外部へのデータ送信が物理的に発生しない「ローカルLLM」を第一選択とします。やむを得ずクラウドLLMを利用する場合は、事業者と法人向けプランの契約を締結した上で、入力データの再学習を行わない(オプトアウト)環境に限定し、かつ管理者が事前に承認したプロンプト経由でのみ利用を許可します。(参考:4,5)
【データ定義・該当例】
●重要プライバシー情報:
患者の要配慮個人情報(医療カルテ等)、大規模な顧客個人情報データ
●極秘情報
未公開のM&A情報、未公開の知的財産・特許明細、役員限定の極秘会議資料、コアシステムのソースコード
●非公開情報・社内限定データ
利用条件が明確に定義された法人向けクラウドサービスで限定利用するのが標準的です。アクセス制御やデータ分類の徹底が必須となります。事業者側での再学習にデータを使用させない「オプトアウト設定」による境界防御が保証された法人契約のクラウドLLMを採用することで、十分安全に利用できます。(参考:5,6)
【データ定義・該当例】
社内業務マニュアル、特定の部署間のみで閲覧する業務知識・ノウハウ、社内会議の要約・議事録、一時的なビジネスメールの文案作成
●一般に公開されている情報
商用・Web版を含む一般的なクラウドLLMを幅広く柔軟に活用して問題ありません。セキュリティ上のリスクが極めて低いため、最も利便性が高く高性能なクラウドLLMを活用することで、大幅な業務効率化を図ることができます。
【データ定義・該当例】
すでに自社Webサイト等で一般公開している広報資料の要約、Web検索結果や公開済み記事の整理、外国語ニュースサイトの翻訳など
▶︎自社のAI技術習熟度とインフラ運用リソース
ローカルLLMの自社構築を成功させるには、社内のAI技術習熟度に加え、インフラを継続的に運用・保守できるエンジニアリソースや予算を冷静に見極める必要があります。どれほど高いセキュリティ要件を満たせていても、維持管理体制やコストが伴わなければ運用は破綻してしまいます。自社の体制を客観的に評価したうえで導入を検討することが不可欠です。(参考:8)

▶︎ハイブリッド構成という第三の選択肢(重要データのみローカル処理)
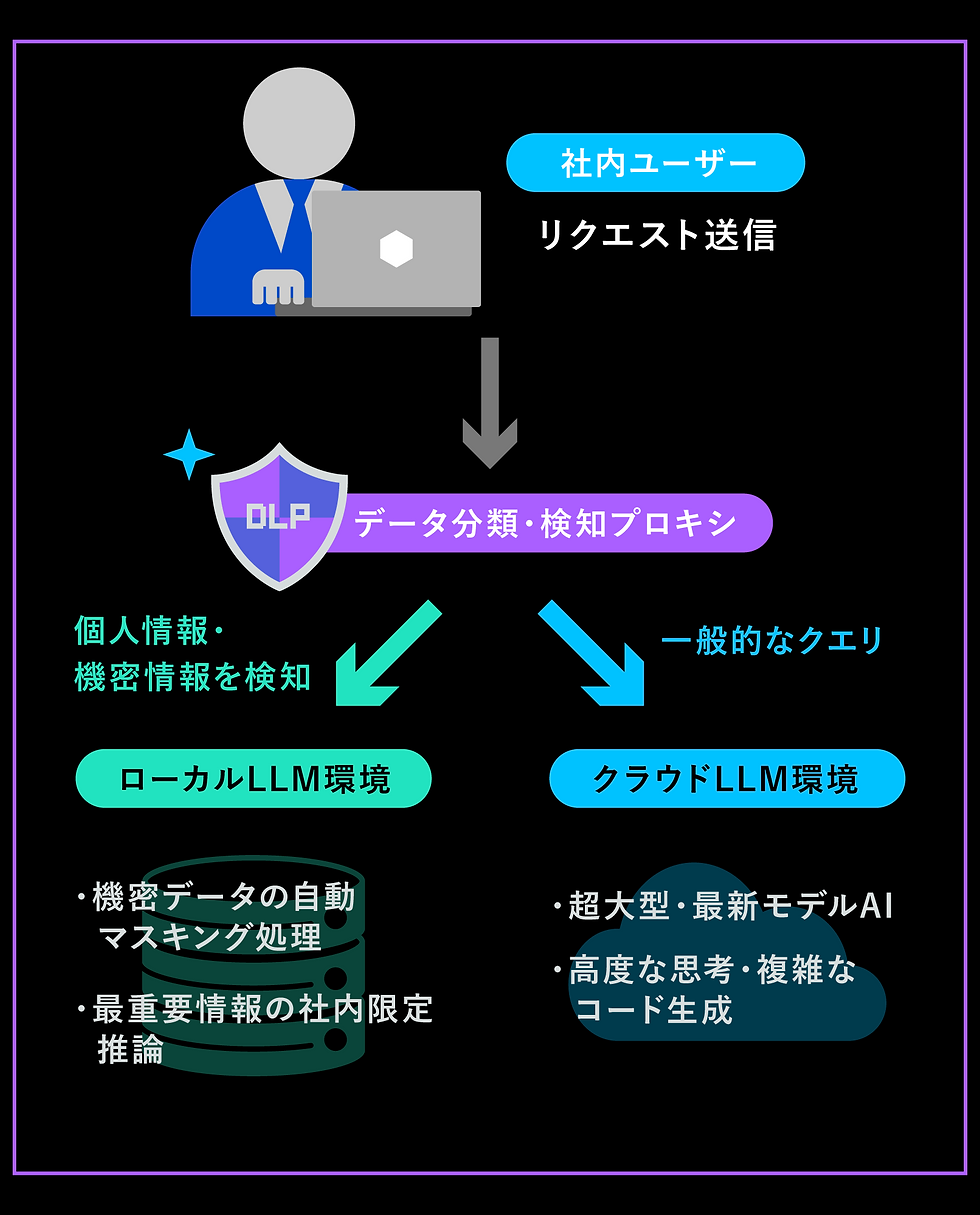
多くのセキュリティ専門家が有効な選択肢として挙げるアプローチが、クラウドLLMの高度な知性とローカルLLMの堅牢性を組み合わせた「ハイブリッド構成」です。
たとえば、ユーザー向けサポート窓口はAzure OpenAIで高速応答しつつ、社内コンプライアンス調査はローカルLLMで実行するといった分離です。ハイブリッド構成を取る場合、ルーティング層(どちらのLLMに投げるか)とデータ分類ラベルの運用がガバナンス上の要になります。(参考:6,8)
ハイブリッド構成のメリット
●セキュリティの自動化
前段に設置したプロキシサーバー(データガード)が、プロンプトに含まれる個人情報(PII)や機密キーワードを自動検知して伏字化(マスキング)またはローカル処理へ分岐させます。
●コストの最適化
日常的な簡単な要約や定型質問はローカルLLM(無料の軽量オープンソース)で処理してクラウドAPI料金を削減し、高度な推論のみをクラウドLLMへ委託します。
●ベンダーロックインの回避
単一のクラウドベンダーに依存せず、マルチLLM構成を柔軟に組むことが可能になります。

安全にLLMを活用するためのセキュリティ対策

クラウド側は「使わせない」のではなく「使える条件を定義する」運用、ローカル側は「閉域を保つ」だけでなく「継続的に更新する」運用が、両者のリスクを下げます。
▶︎クラウド利用時のガイドライン策定とオプトアウト設定
クラウドLLMを企業レベルで安全に運用するための具体的な実務対策は以下の通りです。
●オプトアウトの徹底とエンタープライズプランの契約
一般的な法人向けプランや大手クラウドのAPI利用では、送信データがモデルの再学習に使用されないことが利用規約で保証されているケースが多くあります。そのため、まずは「追加学習に使用されないこと」が明確に契約に盛り込まれた法人向けプランを採用するのが基本です。
ただし、API利用であってもベンダー側の不正監視目的で、プロンプトのログが外部サーバーに一定期間(30日間など)一時保存されることがあります。機密性の高いデータを扱う場合は、このログ保存自体を無効化する「Zero Data Retention(データ保持ゼロ設定)」の申請・適用まで行うと、より安全です。(参考:4)
●各ガイドラインや法律に準ずる社内生成AIガイドラインの策定
日本初の包括的なAI推進法である、「人工知能関連技術の研究開発及び活用の推進に関する法律(AI法)」や、「AI事業者ガイドライン」、個人情報保護委員会の「生成AIサービスの利用に関する注意喚起等について」、IPAの「AI利用者のためのセキュリティ豆知識」などを参考に社内ガイドラインの策定・周知徹底や社内研修を実施し、従業員の基礎的なリテラシーを高めます。(参考:1,5,6,7)
●シャドーAI対策と検出システムの導入
会社が承認していないAIサービスの使用を防ぐため、CASB(Cloud Access Security Broker)やDLP(Data Loss Prevention)ソリューションを導入し、未許可のAIサービス(無料版ChatGPTや野良AIツール)へのアクセスをWebプロキシでブロックします。組織内で稼働している管理外のAIやチャットボット、SaaS、APIの使用を定期的に監査します。(参考:9)
▶︎ローカル導入時のアクセス制限と暗号化の徹底
ローカルLLMを自社環境にデプロイする場合の必須セキュリティ対策です。
●モデルアセットおよび関連データベースの厳格な暗号化
最重要機密である「モデルの重み(Weights)」を保管・実行する環境を物理的・論理的にアクセス制限された閉鎖空間に隔離します。データの転送時および保存時の双方に強力な暗号化アルゴリズムを適用します。
●セキュリティ・バイ・デザインに基づく継続的な脆弱性診断
物理環境やコンテナ、仮想化サーバーの構築時には、静的解析ツールを用いてソースコードやミドルウェアの脆弱性を早期に検知・対策します。あわせて、NIST SP800-40等に準拠したパッチ適用プロセスを社内運用計画に義務付け、オープンLLMの脆弱性放置を防ぎます。
また、オープンソースモデルやAIフレームワークのサプライチェーンリスクに備え、コンテナイメージの自動スキャンや依存ライブラリのパッチ適用をCI/CDパイプラインへ組み込みます。さらに、定期的なレッドチーミング(擬似攻撃テスト)を実施し、プロンプトインジェクションに対する堅牢性を実証的に評価・強化していきます。
●ゼロトラストアーキテクチャに基づくロールベースアクセス制御
「社内ネットワーク内だから安全」という境界型防御から脱却し、ゼロトラストモデルを採用します。IdP(IDプロバイダ)と連携することで、所属や役職に応じた「モデルへのアクセス権限」や「参照可能なドキュメント(RAG)の制限」を厳格に行い、ログを確実に取得します。
また、RAGのベクトルデータベース等へ個人情報や不要データが混入するのを防ぐため、適切なアノテーション(ラベル付与)ルールを運用します。さらに、プロジェクト終了時や契約満了時には、暗号化消去を用いた確実なデータ廃棄プロセスを実行します。
ローカルLLM・クラウドLLMのセキュリティに関するよくある質問(FAQ)
Q. 法人向けクラウドLLM APIを使っていれば、入力データが再学習に使われる心配はありませんか?
A. 主要な法人向けサービスでは、契約上デフォルトで入力データがモデルの再学習に使用されません。ただし、個人アカウントで契約したWeb版ツールや一部のサードパーティ製AIプラグインでは、利用規約上で「サービス向上のためのデータ利用」が有効になっているケースがあります。必ず企業向け契約を締結し、規約で入力データの非学習が保証されているか確認してください。
Q. ローカルLLMを導入すれば、サイバー攻撃のリスクは完全にゼロになりますか?
A. いいえ、ゼロにはなりません。クラウド経由のデータ漏えいリスクは排除できますが、「自社インフラのOSやミドルウェアの脆弱性」「モデルファイルの不正持ち出し」「社内ユーザーからのプロンプトインジェクション」「アクセス制限不備による社内情報漏洩」といったオンプレミス運用特有のリスクが発生します。自社でのセキュリティ運用責任がより重くなる点に注意が必要です。
Q. コスト面で見た場合、ローカルLLMとクラウドLLMはどちらが有利ですか?
A. 導入初期および中規模利用までは、クラウドLLMが圧倒的に有利です。ローカルLLMは、エンタープライズ向けの高性能GPUサーバー(1台あたり数百万円〜数千万円)や冷却設備、専門のインフラエンジニアの人件費など、巨額の初期固定費が発生します。一方、毎日数百万件のリクエストを24時間ノンストップで処理し続けるような極めて高トラフィックな大規模ユースケースにおいては、長期的にローカルLLMの方が1リクエストあたりの単価が安くなる逆転現象が発生する場合があります。
Q. ローカルLLMに必要なハードウェアはどのくらいですか?
A. モデル規模で大きく変動します。70億パラメータ程度の軽量モデルであればGPU1基で動作します。数百億パラメータになるとA100やH100クラスのGPUと相当量のVRAMが必要になり、電力・冷却コストも増大します。商用サポートを含む国産軽量LLMの活用が現実解として有効です。
Q. 金融・医療・官公庁などの厳格な業界でもクラウドLLMは使えますか?
A. 顧客データや診療情報を外部送信できない業種では、ローカルLLMかハイブリッド構成が事実上の標準解ですが、条件を満たせばクラウドLLMでも十分に利用可能です。実際に多くの金融機関や医療機関で導入が進んでいます。
Q. ハイブリッド構成を採る際の注意点は?
A. 機密レベルのデータ分類ラベルを運用設計に組み込むことが最大のポイントです。「極秘」はローカル、「社内限定」はクラウドのEnterprise、「公開」はクラウドのどの層に何を流すかを定義し、ルーティングはゲートウェイ層で集中管理します。監査ログを両方のLLMから統合的に取得し、インシデント発生時のトレースに備えます。
まとめ
自社のセキュリティ要件に合わせたLLM選定を

生成AIの活用において、「ローカルLLM」と「クラウドLLM」のどちらかが絶対的に優れているわけではありません。最適なLLMの選定は、「データの機密性(何を守るべきか)」と「自社の技術リソース(どこまで対応できるか)」のバランスで決まります。
それぞれのメリット・デメリットを正しく理解し、自社に最適なAI基盤を構築することが重要です。必要に応じて両者の強みを組み合わせた「ハイブリッド構成」も視野に入れながら、安全で持続可能なLLM活用を推進していきましょう。
出典・参考一覧
IPA「AI利用者のためのセキュリティ豆知識」 https://www.ipa.go.jp/digital/ai/security/ai_security_tips.html
IPA「情報セキュリティ10大脅威 2026」 https://www.ipa.go.jp/security/10threats/10threats2026.html
OWASP「OWASP Top 10 for LLM Applications 2026」 https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/
OpenAI「OpenAI におけるエンタープライズプライバシー」 https://openai.com/ja-JP/enterprise-privacy/
個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」 https://www.ppc.go.jp/news/careful_information/230602_AI_utilize_alert/
総務省・経済産業省「AI事業者ガイドライン(第1.2版)」 https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html
内閣府・デジタル庁「人工知能関連技術の研究開発及び活用の推進に関する法律」 https://www8.cao.go.jp/cstp/ai/ai_act/ai_act.html
日本総合研究所「ローカルLLMの可能性 ― オープンなモデルが拓くAI活用の展望」 https://www.jri.co.jp/page.jsp?id=111723
PagerDuty「社内ポリシー違反のAI利用が66%に(調査レポート)」 https://prtimes.jp/main/html/rd/p/000000023.000101675.html